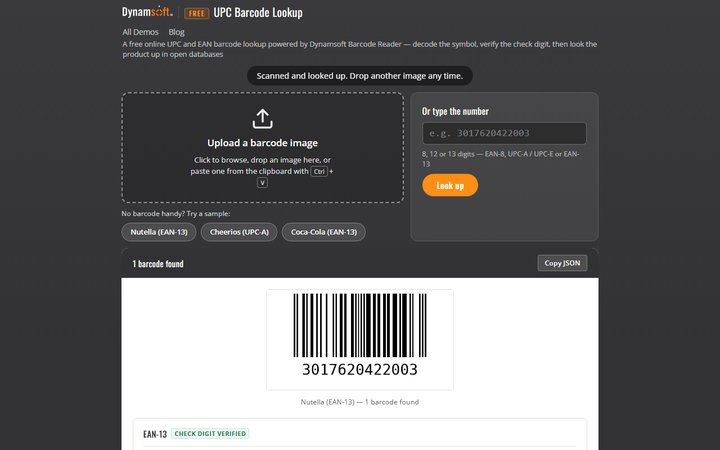
商品条码的查询链路比看起来长:解码拿到一串数字只是开始——校验位要验,UPC-E 要还原成 UPC-A,前缀要解析成注册国家或地区,最后还要去某个数据库把商品查出来。任何一环出错,结果都「看起来正常」:校验位错一位的数字照样查得到东西,UPC-E 没还原就只能查到 8 位号。 在线 UPC 条码查询(英文名 Online UPC Barcode Lookup)把这四步串成一条流水线,页面打开时会自动解码一张内置的商品照片,从解码一路演示到查询结果。
在线演示
在线 UPC 条码查询(英文名 Online UPC Barcode Lookup):上传图片或直接输入条码号都能走完整流程;解码在浏览器内完成,发给开放数据库的只有条码数字本身。
配合本文验证时可以这样走一遍:先看内置示例的逐步输出,再手动输入一个 UPC-E 的 8 位号,观察它被展开成 12 位后前缀和查询走的都是展开后的号码。
关键要点
- 解码支持 UPC-A、UPC-E、EAN-13、EAN-8;校验位按 3、1 交替加权计算并展示算式。
- UPC-E 自动展开回 UPC-A,展开结果的校验位会重新验证。
- GS1 前缀解析为注册国家或地区——是编码注册地,不是产地。
- 商品查询两级回退:Open Food Facts → Open Products Facts,都是 CORS 开放、免 key 的 v2 接口。
- 内置示例是真实零售商品的照片,在 Open Food Facts 里确实存在,每张示例都能完整跑通端到端。
- 解码、分析在本地浏览器完成;查询请求只包含条码数字,图片不外发。
第一步:解码与本地分析
图片解码由 Dynamsoft Barcode Reader 在浏览器内完成(WebAssembly),支持拖拽上传。拿到数字后先做三件纯本地的事:
// 校验位:从右第二位起 3、1 交替加权
function checkDigit(digits) {
  var sum = 0;
  for (var i = digits.length - 2; i >= 0; i--) {
    sum += digits[i] * ((digits.length - 2 - i) % 2 === 0 ? 3 : 1);
  }
  return (10 - (sum % 10)) % 10;
}
- 校验位验证:算式逐步展示,不对时明确标出。
- UPC-E 展开:按数字体系的
ns规则把 8 位压缩码还原成 12 位——后续的前缀解析和查询都用展开后的号码,这一步不还原,后面全是死路。 - GS1 前缀解析:映射到注册国家或地区。页面的措辞是刻意选择的:前缀说明的是这串号码在哪家 GS1 成员组织注册,和「Made in …」是两回事。
第二步:查数据库,以及为什么选它
浏览器页面查商品数据库,第一个门槛不是数据而是 CORS:接口必须显式允许跨域,页面才调得到。这就是选型的关键依据。
UPCitemdb 是这类工具最常被想到的数据源,但它只给自己的域名发 CORS 头,浏览器跨域请求直接被拦,又没有 JSONP 兜底——在纯前端页面里它不可用,再有名也没用。
实际采用的是两个开放数据库的级联:
- Open Food Facts(
world.openfoodfacts.org/api/v2/product/<code>.json):食品覆盖最好,接口带 CORS 头、免 key。 - Open Products Facts(
world.openproductsfacts.org/api/v2/product/<code>.json):食品之外的日用品补充,同一套接口形态。
两级都查不到时,本地分析的结果(校验位、展开码、前缀)仍然有效——它们不依赖任何外部服务。
内置示例的设计
示例图片(sample-images/)全部是真实零售商品的照片,且选品条件只有一条:对应商品在 Open Food Facts 里确实存在。这保证了每张示例从解码到查询结果的每一环都有真实输出可看,而不是一个演示到一半 404 的半截链路。
页面加载时自动解码内置示例,不需要任何点击——打开页面就能看到一条完整的工作链路。想查别的商品,直接输入条码号走同样的流程即可。
边界
数据库是社区维护的开放数据,覆盖取决于录入量:查不到不代表商品不存在,只代表没被收录。识别真实场景里的条码(摄像头、批量图片)请配合在线条码扫描器;图书条码请用在线 ISBN 条码查询,它走的是另一套图书数据源。