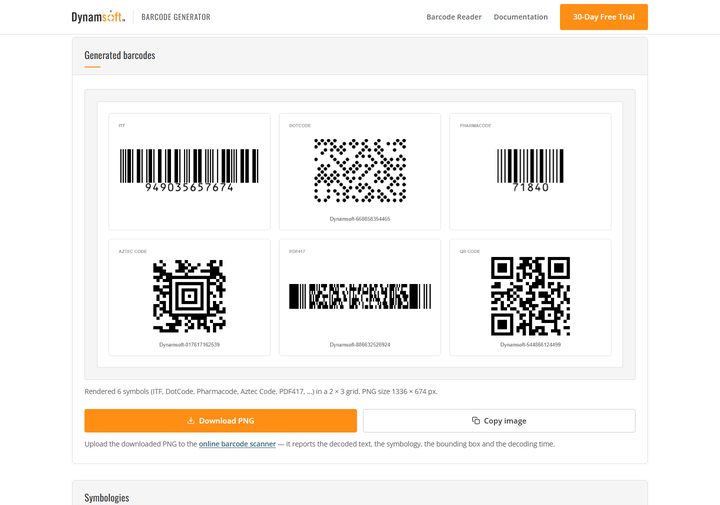
要测试一个扫码应用,最缺的从来不是代码,而是素材:几十张带已知答案、难易可控、还能反复复现的条码图片。在线条码与二维码生成器就是为这个缺口写的——它做两件事:把一段文本编码成 13 种码制中的任意一种(可排成网格一次性复制),以及按一个种子生成整批带精确真值的“模糊-旋转-透视-噪点”测试数据集。
在线演示
在线条码与二维码生成器(英文名 Online Barcode & QR Code Generator):打开就能用,不需要注册,也不需要安装;编码完全在浏览器内完成,生成的图片不会带水印,也不会上传。
配合本文验证时可以这样走一遍:先用「单张图片」模式选一种码制生成一个符号,再切到「模糊测试数据集」,用同一个种子生成两遍,对照导出的 annotations.json 确认码制、内容、退化参数和真值点位完全一致。
关键要点
- 唯一的第三方依赖是
bwip-js@4.11.4(负责编码),没有识别 SDK、没有许可证、没有上传。 - 支持 13 种码制:6 种二维码(QR Code、PDF417、Data Matrix、Aztec、MaxiCode、DotCode)与 7 种一维码(EAN-13、Code 128、Code 39、ITF、MSI、Pharmacode、Codabar)。
- 单图模式最多 6×6 = 36 个符号;数据集模式每张图 1–16 个符号、一份数据集 1–60 张。
- 15 种可调退化(模块尺寸、边距、旋转、逐符号倾斜、透视、裁切、模糊、运动模糊、对比度、JPEG、噪点、不均匀光照、眩光、反色、输出缩放)与 5 档难度预设(clean / easy / medium / hard / mixed)。
- 真值点位是算出来的:透视、旋转、裁切合成为同一个单应矩阵,每个符号的四个角点用同一个矩阵变换,所以标注框的位置由构造保证精确。
13 种码制与各自的取值约束
选择码制之后,输入框的校验规则会跟着变——这一点在生成器里比在扫描器里更重要,因为编码器对不合规的取值会直接抛错。
| 类别 | 码制 | 取值约束 |
|---|---|---|
| 二维码 | QR Code、Aztec、PDF417 | 任意文本,Data Matrix 与 DotCode 容量更小 |
| 二维码 | MaxiCode | 最多 93 个字符 |
| 二维码 | Data Matrix、DotCode | 任意文本,适合小尺寸打标 |
| 一维码 | EAN-13 | 12 或 13 位数字 |
| 一维码 | Code 128 | 任意 ASCII |
| 一维码 | Code 39 | 受限字符集,按正则校验 |
| 一维码 | ITF(交插二五码) | 偶数位数字,生成时统一用 14 位 |
| 一维码 | MSI | 数字,编码时附加 Mod-10 校验位 |
| 一维码 | Pharmacode | 3–131070 的整数 |
| 一维码 | Codabar | 数字,编码时自动补 A/B 起止符 |
一维码统一设置 height: 10(毫米)并打开 includetext,把值打印在条码下方;MSI 额外打开 includecheck。
网格排布:先算尺寸,再画
把多个符号排到一张画布上时,最容易做错的是“先画再缩放”。正确做法是先算出每个单元格需要多大,再决定画布尺寸:
var cellW = content.w + LAYOUT.pad * 2;
var cellH = content.h + LAYOUT.pad * 2 + LAYOUT.label + (content.has2D ? LAYOUT.caption : 0);
return {
  w: LAYOUT.margin * 2 + cols * cellW + (cols - 1) * LAYOUT.gap,
  h: LAYOUT.margin * 2 + rows * cellH + (rows - 1) * LAYOUT.gap
};
单元格尺寸取所有符号里最大的那个宽高,保证网格对齐;只要有一个二维码,就为每个单元格预留一行截断的文本说明。布局常量是 margin: 28、pad: 26、gap: 22、label: 20、caption: 26。
遇到超宽的一维码时,不是把画好的图缩小,而是用更小的整数倍重新编码:
function encode(type, text) {
  return encodeOnce(type, text, type.scale).then(function (canvas) {
    if (canvas.width <= MAX_SYMBOL_PX || type.scale <= 1) return canvas;
    var scale = Math.max(1, Math.floor(type.scale * MAX_SYMBOL_PX / canvas.width));
    if (scale >= type.scale) return canvas;
    return encodeOnce(type, text, scale).catch(function () { return canvas; });
  });
}
按整数倍重画,模块边界始终落在整数像素上;按比例缩小则会模糊模块边缘,直接把一个本来可读的符号变成不可读的。MAX_SYMBOL_PX 取 900。
数据集模式:可复现的“变难”过程
数据集模式的目标不是“生成一堆乱图”,而是生成难度可控、答案已知、可复现的测试集。三个设计决定支撑了这一点。
种子只决定测试用例,不决定像素
种子先经 FNV-1a 哈希,再喂给 mulberry32 伪随机数发生器;每张图再派生出独立的随机流:
function hashSeed(text) {
    var h = 0x811c9dc5;
    for (var i = 0; i < text.length; i++) {
        h ^= text.charCodeAt(i);
        h = Math.imul(h, 0x01000193) >>> 0;
    }
    return h >>> 0;
}
同一个种子必然得到同样的码制、内容、退化参数和真值点位,但像素不承诺逐字节相同——模糊、重采样、JPEG 由浏览器实现。README 里对此的表述是“像素输出不承诺一致,测试用例承诺一致”。另外,退化列表的顺序本身就是随机流的一部分:新增一种退化会改变整个流,所以要么换种子,要么接受旧数据集无法重现。
难度是插值出来的,不是靠加满参数
如果每张图都把全部退化拉满,结果是所有图都读不出来、召回率恒为 0,数据集就失去了区分度。这里的做法是:每张图抽一个难度系数,每个退化值都从“无损端”向抽到的目标值插值:
var draw = randRange(rng, range[0], range[1]);
var neutral = neutralValue(degradation, range);
var value = neutral + (draw - neutral) * difficulty;
applied[degradation.id] = Math.max(degradation.min, Math.min(degradation.max, value));
无损端按退化方向取:越大约糟糕的取区间下限,越小越糟糕的取区间上限,双向的取 0。整数型退化(模块尺寸)会四舍五入。
15 种退化及其默认区间
| 退化 | 说明 | 默认区间 |
|---|---|---|
| Module size | 模块尺寸(px/模块) | 1–6 |
| Frame padding | 画幅留白(相对符号尺寸) | 1.2–4 |
| Rotation | 整幅旋转 | −25°–25° |
| Symbol tilt | 逐符号倾斜(每个符号一个角度) | −180°–180° |
| Perspective | 透视强度 | 0–0.3 |
| Frame kept | 保留的画幅比例 | 0.4–1 |
| Blur | 高斯式盒式模糊 | 0–3 px |
| Motion blur | 运动模糊 | 0–30 px |
| Contrast | 对比度 | 0.3–1 |
| JPEG quality | JPEG 质量并重新解码 | 0.15–1 |
| Noise | 逐通道均匀噪点 | σ 0–30 |
| Uneven lighting | 线性渐变光照 | 0–0.7 |
| Glare | 径向高光 | 0–0.6 |
| Inversion | 反色概率 | 0–0.4 |
| Output scale | 最终重采样比例 | 0.35–1 |
其中“逐符号倾斜”是刻意设计的:整幅统一旋转时,识别器可以估算一次倾斜角复用到所有符号;给每个符号一个独立角度,识别器就必须逐个定位和定向,这才测得出多码场景的真实能力。
所有像素处理都是手写的 JS 循环,不用 WebGL,也不用 ctx.filter——这样不同浏览器上的输出一致,预设参数不会在某浏览器里“悄悄什么也没做”。
真值为什么精确
透视、旋转、裁切被合成为同一个单应矩阵,然后每个符号的四个角点用同一个矩阵变换,再按输出重采样比例整体缩放:
var amp = persp * 0.15 * Math.min(pageW, pageH);
var distorted = corners.map(function (corner) {
    return [corner[0] + (rng() * 2 - 1) * amp, corner[1] + (rng() * 2 - 1) * amp];
});
var perspective = persp > 0 ? solveQuad(corners, distorted) : null;
裁切窗口在透视变换之后才根据实际内容拟合,留 8 px 边距;可见面积不足 MIN_VISIBLE = 0.999 的符号会被丢弃而不是留下一个错误的真值。这两个顺序问题都是踩过坑之后才改的——早先版本在透视之前测量裁切范围,随机抖动会把符号挤出画面,可见性过滤又把这个有效符号删掉,最后基准测试把漏检算到识别器头上。万一某张图的框里一个符号都没留下,会重新抽参数,最多重试 8 次,而不是输出一份空真值。
期望值等于解码值
真值里的文本是“扫描器应该解出来的内容”,不是“输入框里填的内容”。一维码尤其明显:EAN-13 补校验位、MSI 补 Mod-10、ITF 固定 14 位、Codabar 去掉起止符。
rationalizedCodabar: {
    /* 解码器会去掉起止字符,所以真值只保留中间的数字。 */
    format: 'CODABAR',
    payload: function (rng) { return 'A' + digits(rng, 10) + 'B'; },
    expected: function (payload) { return payload.slice(1, -1); }
}
数据集模式下的一维码渲染时不加人眼可读文本,真值框只覆盖条本身——否则标注框会把下方数字也算进去,和识别器返回的条码区域对不上。
导出:annotations.json 与数据集 ZIP
标注文件的顶层结构是自描述的:
{
  "format": "barcode-benchmark/1.0",
  "dataset": "Codepool barcode stress test",
  "generated": "2026-09-17T02:00:00.000Z",
  "total_images": 8,
  "total_barcodes": 32,
  "generator": { "seed": "codepool", "seed_hash": 1234567890, "symbols_per_image": 4 },
  "images": [
    {
      "file": "barcode-stress-499602d2-001.png",
      "width": 1600, "height": 1200,
      "degradations": { "blur": 1.8, "rotate": -12, "jpeg": 0.62 },
      "barcodes": [ { "text": "DS-0001-0002", "format": "QR_CODE", "points": [[412,233],[688,241],[691,517],[409,509]] } ]
    }
  ]
}
degradations 只记录实际生效且严重度超过 0.02 的项,按严重度从高到低排列。数据集 ZIP 里同时打包 annotations.json 与 images/ 目录,用的是自己实现的 ZIP 写入器:store 存储方式、每条 CRC-32、本地文件头与中央目录都按规范写全,所以任何解压工具都能打开——这一点是有意为之的,数据集不应该只有 Dynamsoft 的工具能读。
实测效果
README 记录了一组在 DBR 11.6.3200 上的实测数据,可以作为难度预设的参照:
| 预设 | 期望条码数 | 召回率 | 准确率 |
|---|---|---|---|
| Clean | 8 | 100% | 100% |
| Easy | 16 | 93.8% | 93.8% |
| Medium | 32 | 81.3% | 100% |
| Mixed | 32 | 65.6% | 100% |
| Hard | 46 | 17.4% | 88.9% |
难度阶梯是单调下降的,说明退化参数确实在起作用;Hard 档准确率仍接近 90%,说明剩下的错误基本是漏检而不是误读。
常见问题
这个生成器需要 Dynamsoft 许可证吗?
不需要。它只用 bwip-js@4.11.4 这一个第三方库做编码,没有引入任何识别 SDK,属于纯前端页面,生成的图片也不会加密或加水印。
为什么期望值和我输入的文本不完全一样?
因为期望值记录的是符号实际解码出来的内容,不是输入框里的文字。EAN-13 会补上校验位、MSI 会补上 Mod-10 校验位、Codabar 会去掉起止字符,ITF 固定用 14 位数字——照输入原样记录真值,会让一个正确的扫描器被判成错的。
用同一个种子能生成完全一样的图片吗?
测试用例完全一致,像素不保证逐字节相同。模糊、重采样和 JPEG 编码由浏览器实现,不同浏览器或不同版本可能有细微差别;种子保证的是码制、内容、退化参数和真值点位这些定义数据集的东西不变。
导出的数据集能喂给别的扫描器用吗?
可以。ZIP 是标准格式(store 存储方式加每条 CRC-32),annotations.json 是自描述的 barcode-benchmark/1.0 结构,任何扫描器都可以按自己的方式消费它,不依赖 Dynamsoft SDK。
一张图里最多能放多少个条码?
单图模式最多 6 行 6 列共 36 个符号;数据集模式每张图最多 16 个符号、一份数据集最多 60 张。
生成器只做编码,不做业务
需要说清楚边界:这个工具生成的是原始码制符号,不会替你拼业务层载荷。GS1 元素串、vCard、AAMVA 这类带语义的载荷有各自的生成器——例如 GS1 条码生成器会同时给出“扫描器应该返回什么”的对照表,AAMVA 驾照条码生成器会按辖区拼出完整驾照载荷。
相关阅读
- 如何编写一个在线二维码生成器——从零写一个二维码生成页面的过程。
- vCard 名片二维码在前端的生成与扫描——把 vCard 载荷编码进二维码并读回来。
- 如何用 Python 生成 QR 二维码——同一件事在 Python 侧的做法,含数字、字母数字、字节、汉字模式与结构化追加。
- 如何生成带矢量条码的 PDF 并读码——需要打印场景时,矢量条码比 PNG 更合适。
- 条码识别速度究竟可以有多快?——用真实图片集衡量识别速度与准确率。