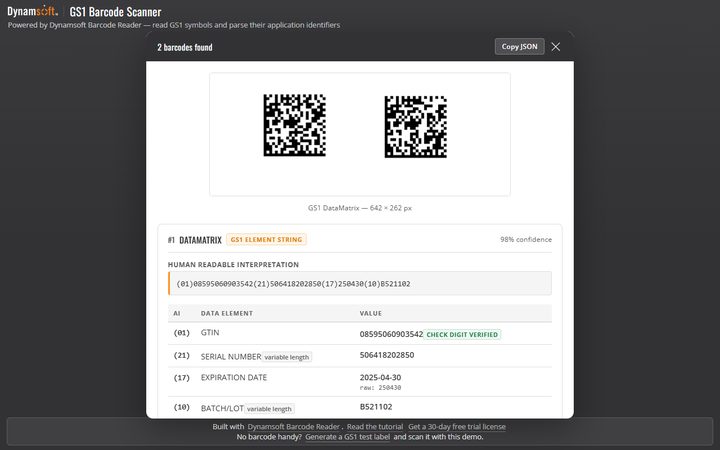
GS1 条码的难点不在解码,而在解码之后。识别器还给你的是 01095060012345671725043010LOT-4221 这样一串字符——里面没有任何分隔符,你必须知道 AI 01 定长 14 位、AI 17 定长 6 位、AI 10 变长最多 20 位,才能把它切成 (01)…(17)…(10)…。在线 GS1 条码扫描器演示的就是这一步:解码、切分、校验、格式化,最后给出具名字段而不是一串数字。
在线演示
在线 GS1 条码扫描器(英文名 Online GS1 Barcode Scanner):打开就能用,不需要注册,也不需要安装;图片和摄像头画面都在浏览器本地解码,不会上传到服务器。
配合本文验证时可以这样走一遍:上传一张商品条码照片,对照结果面板里的 AI 表逐行核对,重点看变长字段那一列有没有标注「变长」、校验位那一列显示的是「通过」「错误」还是「—」。
关键要点
- 解码用
dynamsoft-barcode-reader-bundle@11.6.3200,解析用 Dynamsoft Code Parser 的GS1_AI规范,并提供一份 95 个 AI 的本地表作为回退。 - GS1 码制范围包含 24 个格式名:7 种 DataBar 变体、GS1 Composite、Data Matrix、QR Code / Micro QR、Code 128 / 39 / 93、ITF、EAN-13/8、UPC-A/E、PDF417 系列、Aztec、MaxiCode、DotCode。
- AI 匹配必须最长优先(先试 4 位,再 3 位,再 2 位)——GS1 标准保证 AI 是前缀无关的,不存在“两位 AI 是三位 AI 前缀”的情况。
- FNC1 分隔符有三种常见写法(0x1D 字节、
{GS}占位符、AIM 的]C1前缀),解析前统一归一成|。 - DataBar、ITF-14、EAN-13 只承载 GTIN,符号本身不写 AI 01,需要按码制推断。
从像素到字段的四个阶段
| 阶段 | 用什么 | 产出 |
|---|---|---|
| 解码 | DBR(ReadBarcodes_Balance 模板) |
原始文本与码制 |
| 归一 | 本地 normalize() |
分隔符统一为 | |
| 切分 | AI 表 | AI / 数据元名称 / 值 |
| 校验与格式化 | 校验位算法、日期与计量换算 | 人眼可读值与诊断 |
界面上的每一个条码卡片都对应这四步的结果:码制标签、GS1 element string 徽标、置信度、人眼可读串(HRI)、AI / 数据元 / 值 表格、逐条警告,以及一组事实(解析来源、产品标识、GS1 Digital Link、元素串、分隔符情况、字节数)。
AI 匹配:为什么必须最长优先
/* 在 pos 处解析 AI。GS1 标准里 AI 是前缀无关的——不存在某个两位 AI
   是某个三位或四位 AI 的前缀——所以最长优先匹配没有歧义。 */
function matchAI(text, pos) {
    for (var size = 4; size >= 2; size--) { /* … */ }
}
四位 AI 里最大的一块是计量类:三位家族码加一位小数位,例如 3103 是“净重(kg),3 位小数”。示例覆盖 59 个三位家族(310–316、320–329、330–337、340–349、350–355、356/357、360–369、390–395),也就是 590 个可解析的四位计量 AI。带 ISO 货币代码的 391x 与 393x 例外,字段长度是 9 位而不是 6 位。
变长 AI 的处理是另一个关键分支:先找下一个分隔符,读到分隔符为止;如果一路读到结尾都没有分隔符,说明解码器把它丢掉了,此时会尝试把超长的值拆成两段——头部是一个合法 AI 的值,尾部能被完整解析:
function splitOverlongVariable(code, entry, value) {
    for (var length = Math.min(entry.max, value.length - 1); length >= 1; length--) {
        var head = value.slice(0, length);
        var tail = value.slice(length);
        var tailResult = parseElementString(tail, {});
        if (tailResult.errors.length === 0 && tailResult.count > 0) { /* 拆分成功 */ }
    }
}
拆分方向是“头部尽量长”而不是“头部尽量短”。原因很实在:1215270827 这样的超长值,按最短优先会切成 AI 30 = 1 加 AI 21 = 5270827,两个字段都“看起来合理”但都不是原始数据;按最长优先能尽量把数据留在编码器真正声明的那个字段里,凭空造出的元素最少。
FNC1 的三种写法
/* FNC1 这个 <GS> 分隔符在现实里有三种形态:字面字节 29、
   某些解码器打印的 "{GS}" 占位符、以及 AIM 符号标识约定里的 "]C1"。
   统一归一成 "|",让解析器和界面都只面对一种表示。 */
var SEP = '|';
归一之后还会去掉首尾的分隔符:开头那个是在声明“这是 GS1 符号”(AIM 约定),结尾那个只是补位,两者都不分隔任何数据元素。
裸 GTIN:符号本身就是声明
DataBar 全家族、ITF-14 和 EAN-13 只能装 GTIN,编码里不写 AI 01。扫描器先按码制判断,再在文本开头确实是 12–14 位数字时补上 01:
function omitsGtinAI(format) {
    if (!format) return false;
    if (/Composite/i.test(format)) return true;
    return /DataBar/i.test(format) && !/Expanded/i.test(format);
}
注意 Expanded 系列被排除在外——DataBar Expanded 可以承载多个 AI,不是裸 GTIN 符号。推断发生时页面会明确写出来:“符号只承载 GTIN,AI 01 由码制推断”,而不是把结果伪装成解码器原样返回的内容。
校验位:算法一样,但覆盖范围要说清楚
GTIN、SSCC、GLN、GSRN 用的是同一套 Mod-10 算法:从校验位左边一位开始,权重按 3、1 交替向高位推进(最右边的数据位权重为 3),求和后取 (10 − sum mod 10) mod 10。
function checkDigit(data) {
    var sum = 0;
    var weight = 3;
    for (var i = data.length - 1; i >= 0; i--) {
        sum += Number(data.charAt(i)) * weight;
        weight = weight === 3 ? 1 : 3;
    }
    return String((10 - (sum % 10)) % 10);
}
判定结果有三种,页面上分别显示为“校验位通过”“校验位错误”“—”。这里有一个必须讲明的边界:示例中带校验位规则的 AI 是 00(SSCC)、01/02(GTIN)、8017/8018(GSRN),而 GLN 类 AI(410–417)没有参与校验,显示为“—”。也就是说,看到 (414)… 时不要把它当作已校验的号码。这是在线的演示工具,覆盖范围以页面实际显示为准。
校验位不通过时的提示是具体可行动的:“校验位错误——期望 2,符号里是 7。符号多半被误读了。”而不是一句泛泛的“数据无效”。
日期、计量与 GS1 Digital Link
解析结果不是原样输出,而是转成人能直接看的形式:
- 日期 AI(11、13、15、17 等)按“00–49 是 20xx,50–99 是 19xx”窗口换算,日=00 表示当月最后一天。
- 计量 AI 去掉定长字段的前导零(
000250是 0.250,不是 000.250),并补上单位或货币名称。 - GS1 Digital Link:以
01或8006作主键,10、21、22、235、254、400–403放进路径限定符,其余 AI 变成查询参数,值经过 URL 编码。没有主键时会明确写“没有 GTIN 或 ITIP,无法构造 Digital Link”。
诊断信息比结果本身更有用
解析器对每种失败都给出定位到字符偏移的说明,而不是笼统报错:
- 无法识别的 AI:
Unrecognised AI at offset 27 ("…")。从这一点往后元素串无法可靠切分。并停止解析。 - 定长字段被截断:
AI 17(有效期)需要 6 个字符,但只剩 4 个。 - 变长字段为空:
AI 10(批次)没有数据。 - 变长字段超长且无法拆分:
AI 10 携带 26 个字符,上限是 20。——这正是“解码器吞掉 FNC1”的典型征兆。 - 元素个数超过 200:直接停止,避免畸形数据把页面卡住。
界面上还会单独显示分隔符情况,三种之一:FNC1 (0x1D) 存在——共 N 个分隔符、没有返回分隔符——AI 表按自身长度规则切分、不需要分隔符——所有元素都是定长。这一行往往能直接指出问题出在解码器还是在数据本身。
相机与图片两条路径
- 相机:
startCapturing()持续解码,用MultiFrameResultCrossFilter开启帧间去重(否则同一符号每秒会触发几十次结果面板刷新)。相机打开失败时自动回退到上传模式,不会把用户留在黑屏上。 - 图片:
capture()单次解码,图片先被转成原始的 RGBA 字节缓冲:
return {
    bytes: new Uint8Array(pixels.data.buffer, pixels.data.byteOffset, pixels.data.length),
    width: width, height: height,
    stride: 4 * width,
    format: 10 // IPF_ABGR_8888
};
这是 SDK 内部处理选图时构造的同一种结构。传 Blob、HTMLImageElement 或 canvas 会走另一条内部路径,那条路径会静默返回空结果——不是报错,是“什么也没读到”,很难排查。另外 capture() 会接管传入的字节缓冲,所以每次调用都要构造新的对象。
格式范围有两档:默认“GS1 码制”把 24 个格式名对应的枚举值按位或成一个 BigInt 掩码写进 ReadBarcodes_Balance 模板;“全部码制”则直接用 BF_ALL。切换范围需要先 stopCapturing(),改完设置再重新开始——因为 singleFrameMode 之类的设置必须在相机关闭状态下修改。
代码层面的两个坑
BarcodeFormatIds 在模板 JSON 里写的是名称,在简化设置对象里是数值掩码,而且 BF_ALL 单独一个值(18446744069414584319)就超出了 JavaScript 安全整数范围。手写模板 JSON 混用两套写法,会在 startCapturing() 阶段收到 [-10038] BarcodeFormatIds: The parameter value is invalid or out of range——报错指名道姓说格式列表有问题,真正的原因却是模板本身。
另一个是 fetchImage():在取景器还没产出任何帧时它会抛 getImageData: Value is not of type 'long',所以相机路径用 startCapturing() 加结果接收器,而不是自己写取帧循环。
常见问题
GS1 条码和普通 Code 128 有什么区别?
区别在数据约定,不在编码方式。GS1-128 就是 Code 128,只是最前面多一个 FNC1 字符声明“这是 GS1 数据”,后面按应用标识符组织。有些 GS1 符号(DataBar、ITF-14、EAN-13)甚至只承载一个 GTIN,连 AI 01 都不写出来——符号本身就是“这是 GTIN”的声明。
为什么 DataBar 读出来的结果没有 (01) 前缀?
因为它的编码里确实没有。DataBar 只能装 GTIN,扫描器识别到码制后推断出 AI 01 并明确标注这是推断结果,而不是把 14 位数字直接当正文显示。
AI 10(批次)会不会把后面的序列号也吃进去?
如果解码器丢掉了 FNC1 分隔符,就会。AI 10 是变长字段(上限 20 字符),没有分隔符时它会一直读到字符串结尾。示例的做法是:读出的值超过 AI 允许的长度时,尝试把它拆成“一个合法头部 + 一个能完整解析的尾部”,并给出警告。
校验位不对说明什么?
说明符号很可能被误读了。校验位只能校验数字抄写是否正确,不携带任何防伪能力。示例对 GTIN、SSCC、GSRN 会校验并报告结果;GLN 类 AI(410–417)没有参与校验,页面上会显示为“—”而不是“通过”。
没有 Code Parser 许可证时这个页面还能用吗?
能。页面内置了一份 95 个 AI 的本地表,Code Parser 不可用时会自动回退到本地解析,结果结构完全一样,界面上会注明解析来源(Dynamsoft Code Parser (GS1_AI) + 内置 AI 表 或 内置 AI 表 — Code Parser 不可用)。
自测闭环:先用生成器造,再用扫描器读
这两个工具是成对设计的。用 GS1 条码生成器按真实场景(医药单元、生鲜计重、物流集货箱、退换货资产等)拼出元素串,它会同时给出“符合规范的扫描器应该返回什么”的对照表,然后把导出的标签 PNG 拿到扫描器里读回来逐项核对。11 个场景在两轮随机化载荷下都通过往返验证。
相关阅读
- 如何读取条码中的二进制数据——原始字节层面的处理,和 GS1 文本解析正好互补。
- 条码扫描,使用 ZXing、ML Kit 和 Dynamsoft——不同识别引擎在 GS1 场景下的表现对比。
- 二维码识别 SDK 性能测试与比较——评估识别器时的测试方法。
- 前端扫描 EAN/UPC 格式的条形码及其附加码——零售码制中与 GTIN 关系最近的一类。