证件底部的机读区看起来只是一段怪异的字符,实际上它有严格的规定:几行、每行多少个字符、哪几个位置是字段、校验位怎么算,全部写在 ICAO 9303 里。写 MRZ 解析代码时,最先卡住的问题通常是“我手上没有合法的 MRZ 可以测”。在线 MRZ 生成器就是为这个问题写的:选证件类型、填字段,得到一行合法的、校验位正确的机读区。
在线演示
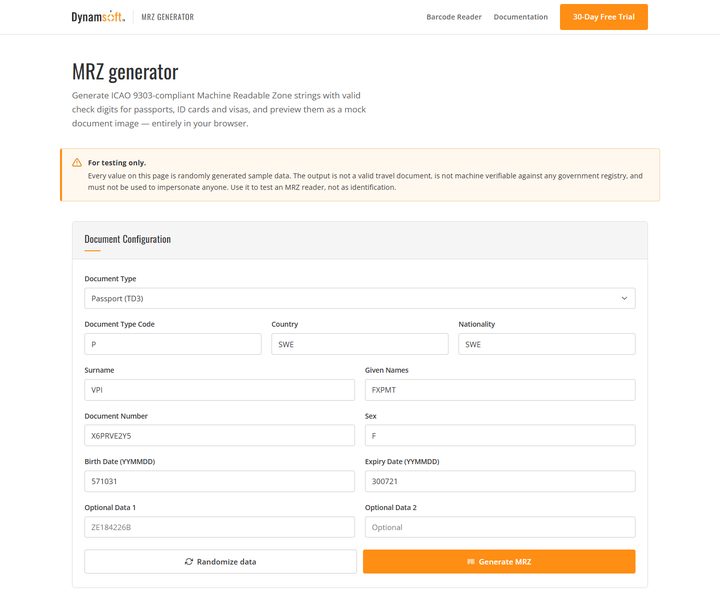
在线 MRZ 机读区生成器(英文名 Online MRZ Generator):打开就能用,不需要注册,也不需要安装;生成与渲染全部在浏览器内完成,输入的内容不会上传。
配合本文验证时可以这样走一遍:依次切换护照(TD3)、身份证(TD1/TD2)和两种签证格式各生成一次,对照本文的行结构表数一遍每行的字符数,再点「随机数据」看校验位和复合校验位是怎么跟着变的。
关键要点
- 纯前端页面,没有 SDK、没有许可证、没有上传;核心逻辑是一个独立的 MRZ 生成模块。
- 覆盖五种格式:护照 TD3、身份证 TD1、身份证 TD2、签证 MRV-A、签证 MRV-B。
- 校验位按 ICAO 9303 的 7-3-1 加权算法计算;TD3 与 TD1 还额外生成复合校验位(TD2 与两种签证格式没有)。
- 字段一律用填充符
<补齐到固定宽度,姓名中的空格在编码时替换为<。 - 画布上渲染一张模拟证件预览,机读区按固定字宽逐字符居中排布。
五种格式的行结构
选不同的证件类型,生成的行数与宽度都不同,字段布局也随之变化:
| 证件类型 | 行数 × 宽度 | 第一行 |
|---|---|---|
| 护照(TD3) | 2 × 44 | 证件代码(2) + 国家(3) + 姓名区(39) |
| 身份证(TD2) | 2 × 36 | 证件代码(2) + 国家(3) + 姓名区(31) |
| 身份证(TD1) | 3 × 30 | 证件代码(2) + 国家(3) + 证件号(9) + 校验(1) + 可选区1(15) |
| 签证(MRV-A) | 2 × 44 | 证件代码(2) + 国家(3) + 姓名区(39) |
| 签证(MRV-B) | 2 × 36 | 证件代码(2) + 国家(3) + 姓名区(31) |
第二行(TD1 的第三行是姓名区):
| 证件类型 | 第二行结构 |
|---|---|
| TD3 | 证件号(9)+校验, 国籍(3), 出生(6)+校验, 性别(1), 有效期(6)+校验, 可选(14)+校验, 复合校验(1) |
| TD2 | 证件号(9)+校验, 国籍(3), 出生(6)+校验, 性别(1), 有效期(6)+校验, 可选(7)+校验 |
| TD1 | 出生(6)+校验, 性别(1), 有效期(6)+校验, 国籍(3), 可选2(11), 复合校验(1) |
| MRV-A | 证件号(9)+校验, 国籍(3), 出生(6)+校验, 性别(1), 有效期(6)+校验, 可选(16) |
| MRV-B | 证件号(9)+校验, 国籍(3), 出生(6)+校验, 性别(1), 有效期(6)+校验, 可选(8) |
几处容易记错的差异:TD1 的证件号在第一行而不是第二行;TD1 的姓名在第三行;MRV-A 的可选区是 16 字符且不带校验位;可选区长度在五种格式里分别是 14、7、15+11、16、8。这些数字写错一个,整行的字段位置就全错。
证件代码本身也占 2 个字符,输入 P 会被补成 P<。界面的提示里给出了合法取值的例子:P、PD、ID、IP。
字符值与校验位
MRZ 的字符集只有三类,换算规则是固定的:
| 字符 | 值 |
|---|---|
< |
0 |
0–9 |
0–9 |
A–Z |
10–35 |
校验位就是这套换算加上 7-3-1 循环加权:
static calculateCheckDigit(data) {
    const weights = [7, 3, 1];
    const charValues = { '<': 0, '0': 0, /* … */ 'Z': 35 };
    let total = 0;
    for (let i = 0; i < data.length; i++) {
        const char = data[i].toUpperCase();
        const value = charValues[char] !== undefined ? charValues[char] : 0;
        total += value * weights[i % 3];
    }
    return (total % 10).toString();
}
注意权重是从字段首字符开始按 7、3、1 循环的,这和 GS1 的校验位算法(从右往左按 3、1 交替)不是同一套,不要混用。
填充函数保证每一段都恰好是规定长度——短了补 <,长了截断:
static pad(str, length) {
    str = str || '';
    return (str + '<'.repeat(length)).substring(0, length);
}
姓名的处理是“转大写 + 空格换成填充符”,姓名区整体是 姓 + '<<' + 名:
const names = this.surname + '<<' + MRZGenerator.formatNames(this.givenNames);
const namesField = MRZGenerator.pad(names, 39);
<< 是姓与名之间的约定分隔符,名字内部原本的空格也会变成单个 <。
复合校验位
TD3 与 TD1 的最后一位是复合校验位,它校验的是前面若干“字段 + 各自校验位”的拼接结果。两者的拼接顺序不同:
// TD3
const compositeData = docNum + docNumCheck + birth + birthCheck
                    + expiry + expiryCheck + optional + optionalCheck;

// TD1
const compositeData = docNum + docNumCheck + optional1 + birth + birthCheck
                    + expiry + expiryCheck + optional2;
TD2、MRV-A、MRV-B 都没有复合校验位,生成时不要多补一位——多一位会让整行长度超出规范,解析器会直接判为格式错误。
国家代码
生成器只做一条归一替换:
static normalizeCountryCode(code) {
    const overrides = { 'DEU': 'D' };
    const upper = (code || '').toUpperCase();
    return overrides[upper] || upper;
}
德国在机读区里被写成 D 而不是 ISO 3166 的三字母代码 DEU,这是 ICAO 9303 的明文例外。其余国家代码按输入的三字母大写原样使用,生成器不校验它是否合法——如果你填了一个不存在的代码,生成的 MRZ 在结构上仍然是合法的。
随机样本数据
“随机数据”按钮会填一整套自洽的样例:姓名是 3–7 位大写字母,国籍从 19 个常见国家代码里挑,性别 M/F 各半,证件号是 9 位字母数字混合,出生日期在 18–80 年前,有效期在 1–10 年后。日期生成考虑了月份长度与闰年:
if ((year % 4 === 0 && year % 100 !== 0) || year % 400 === 0) { // 闰年
    day = randomIntFromInterval(1, 29);
} else {
    day = randomIntFromInterval(1, 28);
}
日期在机读区里是 YYMMDD 六位,由 toISOString() 截取后去掉横线得到。注意这里生成的是两位年份,所以预览里显示的日期需要一个世纪还原逻辑(年份大于 50 归入 19xx,否则 20xx)——这也是 MRZ 解析端必须处理的同一件事。
画布预览:为什么逐字符绘制
预览画布按证件类型取不同尺寸(TD3 为 900×640,其余 900×580),先铺一层按国家取色的渐变底、撒 50 个半透明圆点做纹理,再叠正弦纹路的底纹、4 px 微缩文字、角部防伪块、圆形徽标与标题(PASSPORT / IDENTIFICATION CARD / VISA)、人像占位区和两列字段,最后是机读区,末尾盖一个 8% 透明度的红色 SPECIMEN 水印。国家配色表有 22 项,其中 D 是 DEU 的别名,注释里也写明了这个别名存在的原因。
机读区的绘制方式是这个预览里最值得借鉴的一处。它不依赖字体本身的等宽特性,而是先算出每个字符格的宽度,再把每个字符单独画在格子里居中:
const mrzAvailableWidth = docWidth - 100;
const maxLineLength = Math.max(...lines.map(line => line.length));
const charWidth = mrzAvailableWidth / maxLineLength;
let y = mrzY + mrzPadding;
for (let line of lines) {
    let currentX = mrzStartX;
    for (let i = 0; i < line.length; i++) {
        const char = line[i];
        const charMeasure = ctx.measureText(char);
        const charOffset = (charWidth - charMeasure.width) / 2;
        ctx.fillText(char, currentX + charOffset, y);
        currentX += charWidth;
    }
    y += 30;
}
这样做的好处是:无论浏览器实际用哪个字体渲染,字符都会落在规范要求的位置上。真实 MRZ 用的是 OCR-B 字体,而这个页面没有注册 OCR-B 的 @font-face——画布的字体声明里写了 "OCR-B", monospace,在字体缺失时回退到等宽字体。字符格对齐保证了“看起来像机读区”,但如果目标是生成用于测试识别模型的图片,最好自己注册一款 OCR-B 字体,让字形也接近真实证件。
用生成器闭环测试
这个工具与在线 MRZ 与护照扫描器配套:生成一段合法 MRZ、用预览图作为输入、把识别与解析结果和生成时的字段逐项比对。校验位是这套测试里最有价值的部分——如果解析器把某个字符读错,校验位会直接不通过,错误不会悄悄通过。
需要说清楚边界:生成的是格式合法的测试数据,不是真实证件;它不含任何防伪特征,也不能用来冒充真实证件。
常见问题
生成的 MRZ 会不会和某个真实证件重号?
生成器用的是随机样本数据,号码、姓名、日期都是随机组合,不对应任何真实证件。它的用途是测试 MRZ 识别与解析逻辑,以及在没有真实证件的情况下准备演示素材。
校验位是怎么算出来的?
按 ICAO 9303 的 7-3-1 加权:从字段首字符开始依次乘 7、3、1 循环,字符值按“填充符 < 为 0、数字 0–9 为其本身、字母 A–Z 为 10–35”换算,求和后取个位数(总和对 10 取模)。
TD1、TD2、TD3 有什么区别?
按证件尺寸划分。TD3 是护照(2 行 × 44 字符),TD2 是较薄的身份证(2 行 × 36 字符),TD1 是信用卡大小的身份证(3 行 × 30 字符)。行数与宽度的差异决定了字段怎么切分,也决定哪些格式带复合校验位。
为什么生成器把国家代码 DEU 写成 D?
这是 ICAO 9303 的一条例外规定:德国的机读区国家代码用 D 而不是 ISO 3166 的 DEU。生成器对输入做归一,把 DEU 替换成 D,其余代码按输入的三字母大写原样使用。
生成结果的图片能下载吗?
页面提供的是画布预览,没有单独的下载按钮——可以用浏览器对画布的“图片另存为”或截图取用。预览的目的主要是让人直观确认字段位置与排版,真正的输出物是上面那几行 MRZ 文本。
相关阅读
- 用 Next.js 编写 OCR 护照上 MRZ 的网页应用——把生成的样本接进识别流程。
- 基于 Jetpack Compose 和 CameraX 的护照 MRZ 扫描——原生 Android 端的 MRZ 读取。
- 如何编写一个 Oracle APEX 插件来识别 MRZ 文本——低代码平台的集成方式。
- 前端生成快递单 PDF——另一类“按规范在前端拼出结构化数据”的应用。